
Online Marketing & SEO
Technisches SEO als Grundlage für KI-Sichtbarkeit
SEO ist mal wieder tot und/oder wird von GEO abgelöst, sagen die einen, aber so einfach ist das nicht! Auch wenn der Traffic über organic stetig sinkt und dafür mehr KI-Traffic generiert wird, ist das klassische SEO weiterhin sehr relevant. Nicht nur der Googlebot crawlt die Inhalte, sondern auch die KI-Systeme greifen via Crawler auf die Inhalte zu und lesen diese entsprechend aus. Bevor also eine KI Deine Inhalte zitieren kann, muss sie diese erst einmal erreichen, laden und verstehen können. Und genau dafür sorgt technisches SEO. Ich zeig Dir wie.
KI-Crawler versucht seinen Weg zu finden.
Was ist KI-Sichtbarkeit überhaupt?
KI-Sichtbarkeit beschreibt, ob und wie oft Deine Marke in KI-generierten Antworten auftaucht, ob
- als zitierte Quelle,
- als Empfehlung oder
- als genannter Anbieter.
Die relevanten Systeme sind aktuell vor allem die Google AI Overviews, ChatGPT (inklusive der Websuche), Perplexity, Microsoft Copilot und Gemini.
Die . Die AI Overviews erscheinen mittlerweile bei einem erheblichen Anteil aller Google-Suchen, ChatGPT zählt Hunderte Millionen aktive Nutzer pro Woche, und ein wachsender Teil der Suchanfragen endet ganz ohne Klick auf eine externe Website.
Gleichzeitig zeigen erste Auswertungen, dass Besucher, die über KI-Antworten auf Deine Seite kommen, oft überdurchschnittlich gut konvertieren, denn sie haben ihre Recherche schon hinter sich.
Das Entscheidende dabei: KI-Sichtbarkeit ersetzt SEO nicht. Sie baut darauf auf. Auswertungen zeigen einen klaren Zusammenhang zwischen guten Google-Rankings und AI-Overview-Zitaten – auch wenn die Überlappung mit den Top 10 laut Ahrefs von rund 76 % (Mitte 2025) auf etwa 38 % (Anfang 2026) gesunken ist. Ein Top-Ranking bleibt damit der zuverlässigste Einstieg, ist aber keine Garantie mehr. Wer also in der klassischen Suche unsichtbar ist, taucht meist auch in den KI-Antworten nicht auf. Und: Die Voraussetzung dafür, überhaupt ranken zu können, ist: ein technisch sauberes Fundament.
Basics zum Thema: Crawler und deren Crawlvorgang
Die Bots sind ungeduldig. Sie warten nicht auf langsamen Seiten und kämpfen nicht mit komplexen Java Script-Strukturen. Sie geben auf, wenn der Content nicht direkt verständlich ist. Wer also technisch schlecht aufgestellt ist, existiert für die KI-Systeme zu großen Teilen nicht – egal wie gut der Content ist.
Die Crawler-Landschaft: Wer crawlt überhaupt Deine Website?
Neben den traditionellen Suchmaschinen-Crawlern (Googlebot oder Bingbot), erfassen nun auch KI-spezifische-Crawler (GPTBot, CCBot, OAI-SearchBot, etc.) Deine Website.
Die wichtigsten Bots im Überblick
| Bot | Verwendung |
| GPTBot (OpenAI) | Sammelt Daten für das ChatGPT-Training |
| OAI-SearchBot (OpenAI) | Zuständig für die ChatGPT Live-Recherche der Suche |
| ClaudeBot (Anthropic) | Trainings-Crawler von Claude |
| Claude-SearchBot bzw. Claude-User (Anthropic) | Suchbot für den Echtzeit-Abruf |
| Googlebot | Klassischer Googlebot speist Gemini und AI Overviews |
| PerplexityBot | Crawler für die Perplexity-Suche |
| Applebot-Extended | Für die Apple-KI |
| CCBot | Bot von Common Crawl, diese Daten fließen in viele LLMs ein |
| Bytespider | Crawler der chinesischen Firma ByteDance (u. a. TikTok) |
| Meta-ExternalAgent | Crawler von Meta (Facebook, Instagram, etc.) |
Einige zählen noch Google-Extended als Bot auf, tatsächlich ist das kein Bot, sondern ein Steuer-Token, welcher die nachgelagerte Datennutzung regelt (taucht daher nicht in den Logfiles auf). Also ob mit dem Inhalt Gemini trainiert werden darf, oder nicht.
Interessanter Fakt: Laut einer Studie von WIXSTUDIO stiegen die Suchanfragen über KI-Suchmaschinen im Jahresvergleich um 42,8 % (YoY-Vergleich zwischen Q1/2025 15,7 Milliarden Suchanfragen und Q1/2026 27,4 Milliarden). Es handelt sich also um einen der am schnellsten wachsenden Märkte.
Das Vorgehen der verschiedenen Crawler
Wie die verschiedenen Bots Deine Seite crawlen und wahrnehmen, ist sehr unterschiedlich (zwischen Suchmaschinen und KI-Bots), dies ist jedoch nicht jedem bekannt:
1. Vorgehen klassischer Suchmaschinen:
Suchmaschinen-Bots folgen bestimmten (Link-)Pfaden:
Inhalte crawlen -> ggf. Indexieren -> spezifisches Ranking vergeben
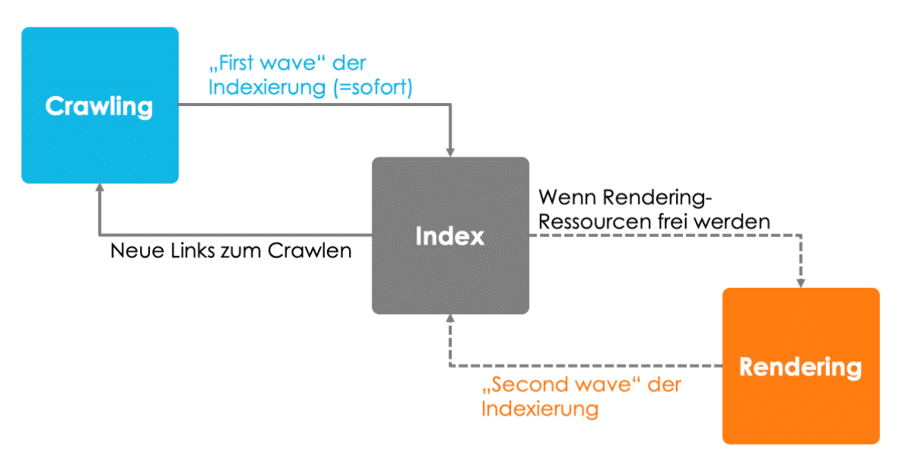
So sieht das Vorgehen beim Crawling vom Googlebot exemplarisch aus. (eigene Grafik)
Der Zeitabstand zwischen First Wave und Second Wave beträgt heute eher Minuten, oft sogar Sekunden, wenn eine Seite stark auf Java Script basiert.
Die Render-Queue
Seiten landen nach dem Crawl nicht sofort im Renderer. Der Googlebot stellt alle Seiten mit einem 200-HTTP-Statuscode zunächst in eine Render-Queue. Wie lange eine Seite dort wartet (also wieviel Zeit zwischen Crawl und Rendering vergeht), hängt von Googles verfügbaren Ressourcen ab. Es können Sekunden sein, aber auch deutlich länger.
Für den Praxisalltag bedeutet das:
- Änderungen, die nur im gerenderten Zustand sichtbar sind, tauchen in der Search Console und im Index zeitverzögert auf.
- Änderungen im initialen HTML hingegen werden schneller erfasst.
Wenn Du mehr dazu Wissen möchtest, schau Dir unbedingt unseren Blogbeitrag zu Cookie-Bannern und SEO an, dort wird näher auf Java Script-Rendering, sowie auf das Problem, dass teils Inhalte erst nach Consent geladen werden können, eingegangen.
Dennoch gilt: Websites, die ihre Inhalte komplett im HTML übergeben, oder Server Side Rendering betreiben, werden vom Googlebot nach wie vor deutlich schneller und effizienter indexiert.
2. Wie KI-Systeme Inhalte aufnehmen und verarbeiten
KI-Bots arbeiten nach einer anderen Logik als klassische Suchmaschinen, denn: Hier geht es mehr um Beziehungen von Entitäten.
Erfassen von Informationen à Umwandlung in Vektoren à kombinieren / vereinen / verknüpfen von Inhalten
- Ingestion – Erfassen von Informationen:
Der Crawler erfasst Inhalte einer Seite, um den Text als Rohmaterial für Sprachmodelle zu sammeln und nicht primär, um sie in einem Index nach Keywords zu sortieren, wie bei klassischen Suchmaschinen. Dabei wird der eigentliche Bedeutungsgehalt extrahiert: Fließtext, Aussagen, Fakten, Zusammenhänge. HTML-Struktur, Navigationselemente oder Keyword-Verwendung spielen eine geringere Rolle als bei klassischen Suchmaschinen.
Wichtig ist, ob der Inhalt klar, eigenständig verständlich und faktisch verwertbar ist.
- Embedding – Umwandlung in Vektoren
Der aufgenommene Text wird in Vektoren umgewandelt, also in numerische Werte, die die Bedeutung abbilden und Vergleiche ermöglichen. Inhalte mit ähnlicher Bedeutung liegen im Vektorraum nahe beieinander, unabhängig von der konkreten Wortwahl. Auch wenn semantische Nähe durchaus für klassische Suchmaschinenbots relevant ist und von ihnen bewertet wird, bleibt dort die klassische Keyword-Optimierung weiterhin wichtig.
Die Qualität der semantischen Zuordnung hat durch moderne, transformerbasierte Embedding-Modelle stark zugenommen. So kann ein Text über „Schmerzlinderung beim Joggen“ für eine Anfrage zu „Knieproblemen beim Laufen“ relevant werden, obwohl kein einziges Wort übereinstimmt.

Starke Vereinfachung von Vektoren (Dall E).
- Synthetisieren – kombinieren, vereinfachen und verknüpfen von Inhalten
Statt eine Liste von Links auszugeben, kombiniert das Modell Informationen aus mehreren Quellen zu einer einzigen, zusammenhängenden Antwort. Es zitiert, verknüpft und formuliert komplett neue Inhalte. Eine Seite „rankt“ hier nicht im klassischen Sinne, sie wird entweder als Quelle in die Antwort eingewoben oder nicht.
Sichtbarkeit bedeutet also: Wird mein Inhalt vom Modell als verlässlicher Baustein für die generierte Antwort herangezogen?
Dabei werden KI-Crawler in zwei Arten eingeteilt:
- Trainings-Crawler: Diese sammeln Informationen für das Training des Sprachmodells (darunter z. B. GPTBot (OpenAI), ClaudeBot (Anthropic) und CCBot (Common Crawl)).
- Such- und Retrieval-Bots: Besorgen sich Inhalte in Echtzeit, um sie in einer konkreten Antwort zu zitieren (z. B. OAI-SearchBot, ChatGPT-User (OpenAI), Claude-SearchBot bzw. Claude-User (Anthropic) und PerplexityBot).
Die 7 wichtigsten Tech-SEO-Hebel für Deine KI-Sichtbarkeit
LLMs beziehen ihr Wissen aus zwei Quellen:
- aus ihren Trainingsdaten und
- aus der Live-Recherche im Web zum Zeitpunkt der Anfrage.
Beide Wege führen über Crawler, die die Domain besuchen, den Inhalt einlesen und weiterverarbeiten.
Und hier liegt der Knackpunkt: Diese Crawler sind in vielerlei Hinsicht anspruchsvoller und gleichzeitig „dümmer“ als der gute alte Googlebot.
Hebel 1: Crawlbarkeit sicherstellen – das unterschätzte Problem
Die größte Bremse ist, wenn die KI-Bots keinen Zugriff auf die Inhalte haben.
Tooltipp:
Die Chrome-Extension “Robots Exclusion Checker” prüft die robots.txt, die Meta Robots, Canonicals und checkt auf gezielt, ob KI-Bots ausgeschlossen werden.
Grundsätzlich gibt es, wie bereits erwähnt, zwei Arten von KI-Crawlern: Suchbots & Trainings-Crawler.
Steuerung über die robots.txt
Möchtest Du Suchbots reinlassen und Trainings-Crawler aussperren, kannst Du das über die robots.txt steuern:
# KI-Suchbots erlauben damit man zitiert werden kann(KI-Sichtbarkeit)
User-agent: Claude-SearchBot
Allow: /
User-agent: Claude-User
Allow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: ChatGPT-User
Allow: /

User-agent: PerplexityBot
Allow: /

# Optional: Trainings-Crawler blockieren
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: CCBot
Disallow: /
Interessanter Fakt
Nicht alle Crawler halten sich an diese Regeln. Einige Bots ignorieren die robots.txt, oder nutzen nicht Denn Verifizieren lässt sich ein Bot nicht allein über den User-Agent (der ist fälschbar), sondern über die veröffentlichten IP-Bereiche oder einen Reverse-DNS-Lookup.
Zudem ist die robots.txt eine Bitte, keine Verpflichtung.
Interessanter Fakt
Nicht alle Crawler halten sich an diese Regeln. Einige Bots ignorieren die robots.txt, oder nutzen nicht Denn Verifizieren lässt sich ein Bot nicht allein über den User-Agent (der ist fälschbar), sondern über die veröffentlichten IP-Bereiche oder einen Reverse-DNS-Lookup.
Zudem ist die robots.txt eine Bitte, keine Verpflichtung.
Blockade auf Server- oder WAF-Ebene
Häufig sitzt die Sperre nicht in der robots.txt, welche Du vielleicht noch im Blick hast, sondern in der Server- oder WAF-Ebene. Ein erheblicher Teil an Websites schließt damit unwissentlich LLM-Crawler aus.
- Server-Ebene: Die Sperre wurde in der Server-Konfiguration eingebaut, z. B. über eine deny-Regel in der nginx- oder Apache-Config, die bestimmte User-Agents abweist. Das funktioniert, die Zugriffe der Bots belasten dennoch den Server.
- WAF-Ebene (Web Application Firewall): Die Blockade wird beim CDN-Anbieter (CDNs wie Cloudflare oder AWS) gesetzt, bevor die Anfrage die Server belasten kann. Viele Dienste wie Cloudflare haben eine Option „KI-Crawler blockieren“, die gerne unbemerkt aktiviert ist.
Die Lösung
Damit die Suchbots die Website zitieren können, sollte nicht nur die robots.txt geprüft werden, sondern auch die CDN- und WAF-Einstellung, sowie die Server-Logs auf 403-Antworten. Denn nur so kann sichergestellt werden, dass die LLMs Deine Website überhaupt zitieren dürfen.
Hebel 2: Java Script – das kritischste Problem für KI-Sichtbarkeit
Der wichtigste Punkt ist, dass basierend auf aktuellen Beobachtungen (Stand März 2026) keiner der großen KI-Crawler – außer Gemini mit dem Googlebot – Java Script rendert.
Weder GPTBot, ClaudeBot, PerplexityBot, Bytespider noch der Meta-ExternalAgent rendern die URLs. Sie laden das rohe HTML, extrahieren die dort gefundenen Informationen und das wars. Was anschließend via Java Script an Informationen hinzugefügt wird, ist für LLMs nicht sichtbar. Somit sind Websites, die auf Client-Side-Rendering setzen für KI-Suchen faktisch unsichtbar.
Doch warum ist das so?
Das ist auf die Kosten und die Herausforderungen an die benötigte Infrastruktur zurückzuführen. Vollständiges Java Script-Rendering mit Headless Chromium erfordert enorme Rechenleistung pro gecrawlter URL und das ist ein großer Kostenfaktor!
Interessanter Fakt:
Laut dem Nachhaltigkeitsbericht von Google hat sich der Energieverbrauch seiner Rechenzentren innerhalb von vier Jahren mehr als verdoppelt: von 14,4 Millionen Megawattstunden 2020 auf 30,8 Millionen Megawattstunden 2024.
Mit rund 31 TWh verbraucht Google allein für seine Serverstrukturen mehr Strom als Länder wie Kroatien, Estland oder Slowenien im kompletten Jahr (inklusive aller Haushalte und der gesamten Industrie). (Nachhaltigkeitsbericht von Google)
Es ist nicht nur ein Kostenfaktor, sondern auch auf deren Einsatzgebiet zurückzuführen:
KI-Crawler wie der GPTBot, ClaudeBot oder PerplexityBot sind primär darauf optimiert, große Textmengen schnell zu verarbeiten. Das für Java Script-Rendering benötigte Headless-Browser-Rendering würde jedoch die Crawling-Geschwindigkeit um den Faktor 10 bis 100 reduzieren.
Die Lösung
- Relevante Inhalte (wie Texte, Überschriften, FAQs etc.) müssen im initialen HTML stehen, nicht erst clientseitig nachgeladen werden.
- Falls es ohne Java Script nicht geht: Durch Server-Side Rendering (SSR) übernimmt der Server das Ausführen der Java Script-Ressourcen und die KI-Bots können alle Inhalte sehen und verarbeiten.
- Alternativ lässt sich Pre-Rendering implementieren, wenn SSR nicht machbar ist.
Tipp: Java Script im Browser deaktivieren und selbst schauen, was von der Website noch sichtbar ist. So sieht das dann auch der KI-Bot.
Hebel 3: Seitenarchitektur & interne Verlinkung – der indirekte Faktor
Während sich Trainings-Crawler wie klassische Bots in der Domain über Links von Seite zu Seite hangeln, machen es die Suchbots anders. Sie greifen auf das RAG-System zurück, aber: Dieses wird aus einem Index gespeist und hier kommt die Relevanz der Links ins Spiel!
Eine klare Architektur und interne Verlinkung helfen, indexiert und gerankt zu werden und damit in den Pool zu kommen, aus dem KI-Systeme ihre Quellen ziehen; beim Beantworten selbst rufen sie dann gezielt einzelne URLs ab.
Quellen der KI-Suchbots
- ChatGPT läuft primär über den Bing-Index, ergänzt durch OpenAIs eigenen Crawler OAI-SearchBot. Heißt: Hier zählt vor allem die Bing-Sichtbarkeit.
- Perplexity betreibt einen eigenen Index und zieht für bestimmte Anfragen zusätzlich Drittanbieter wie Google und Bing heran.
- Gemini & AI Overview nutzen den klassischen Google Index.
- Claude ruft bei aktiviertem Webzugriff Seiten direkt aus dem offenen Web ab. Hier ist es besonders relevant, dass die Seite technisch sauber erreichbar ist.
Da die Quellen der meisten KIs klassische Suchergebnisse sind, ist das klassische SEO-Ranking sehr relevant.
Fazit: Die interne Verlinkung ist kein „KI-Rankingfaktor“, aber sie hilft indirekt. Ob die eigene Domain zitiert wird, hängt davon ab, ob diese gut rankt.
Hebel 4: Pagespeed – die ungeduldigen Bots
Das Thema Pagespeed ist aus zwei Gesichtspunkten wichtig, dem RAG-Index und dem tatsächlichen Echtzeit-Abruf beim Zitieren.
- Pagespeed und der KI-Index:
Suchmaschinen vergeben ein bestimmtes Crawl-Budget. Dabei handelt es sich um ein Zeitfenster, was je nach Domaingröße und Aktualität sehr unterschiedlich ausfallen kann. Ist nun eine Domain extrem langsam, können nur wenige URLs in dieser Zeit verarbeitet werden. Und wenn regelmäßig Fehler ausgespielt werden, brechen die Crawler den Besuch ab und kommen seltener wieder.
Pagespeed beeinflusst nicht direkt die KI-Sichtbarkeit, aber die Sichtbarkeit in den klassischen Suchmaschinen.
2. Pagespeed und der Echtzeit-Abruf beim Zitieren:
ChatGPT Search, Perplexity, Google AI Overviews und Bing Copilot rufen Seiten in Echtzeit ab. Dieser Abruf ist deutlich ungeduldiger als der Googlebot: KI-Crawler arbeiten mit knappen Timeouts von ein bis fünf Sekunden; lädt die Seite zu langsam, überspringen sie diese komplett und wechseln zu anderen, schnelleren Wettbewerbern.
Die Konsequenz: Wenn die Suchbots beim Abruf in einen Timeout laufen, wird diese URL nie als Quelle hinterlegt, egal, wie gut sie ist.
Fazit: Kümmere Dich um Deine Core Web Vitals und um eine solide Server-Performance. Das zahlt doppelt ein: Es verbessert die Nutzererfahrung (und damit klassisches SEO) und sorgt dafür, dass die Bots Deine Inhalte zitieren können.
Hebel 5: Strukturierte Daten – Das Hype-Thema
Aber LLMs crawlen doch gar keine strukturierten Daten! Stimmt nur zum Teil, denn so einfach ist das nicht. Um zu verstehen, was genau da passiert, musst Du etwas tiefer in die Funktionsweise von LLMs und deren Crawlern einsteigen:
Wie das mit LLMs und strukturierten Daten wirklich ist
LLMs haben keinen dedizierten Mechanismus, um JSON-LD als strukturierte Daten auszuwerten, sie arbeiten mit Text. Strukturierte Daten werden aber im Voraus vom Crawler verarbeitet und fließen so in den Suchindex bzw. die Wissens- und Entitätsgraphen ein, aus denen KI-Systeme bei der Beantwortung ihre Quellen ziehen.
Wie es funktioniert:
- Crawler = sammelt und strukturiert im Voraus.
- RAG = wählt zur Anfragezeit passende Quellen aus und liefert die Belege.
- Sprachmodell = formuliert aus den gelieferten Quellen die Antwort.
Somit sind strukturierte Daten eines von vielen Kriterien, die LLMs helfen, thematische Autoritäten einzuschätzen und die Entitäts- und Inhaltsklarheit zu verstehen. Sie verbessern die inhaltliche Zuordnung und erhöhen die faktische Genauigkeit bei KI-Antworten.
Markups und Einbindung von strukturierten Daten
Als Google im Mai 2026 die Unterstützung der FAQPages Auszeichnung für beendet erklärte, war die Aufregung groß und ein vermeitliches Gegenargument geschaffen. Google verwendet das Markup jedoch weiterhin, um die Seiten besser zu verstehen. Somit hat das Markup weiterhin seine Relevanz.
Bei der Einbindung der strukturierten Daten ist zu beachten, dass:
- JSON-LD zu bevorzugen ist – JSON-LD wird geparst.
- keine Java Script Injection stattfindet – Java Script wird nicht geparst.
Folgende Markups können positive Effekte auf die KI-Sichtbarkeit haben:
- Organization: Definiert eine Marke als eigenständige Entität. Ohne das Markup ist der Firmenname für eine KI nur Text. Das Markup vereinfacht es KI-Systemen zu verstehen, dass es sich um eine Marke handelt.
- Wirkungsvoller Hebel ist die Verwendung der sameAs-Eigenschaft: Diese verweist auf weitere verifizierte Profile (Wikipedia, LinkedIn, etc.) und verankert die Marke im Wissensgraphen. Das Markup sollte site-weit ausgespielt werden.
- Article (bzw. BlogPosting): Liefert Autoren- und Aktualitätssignale und kann die Glaubwürdigkeit steigern.
- Wichtige Felder sind: author, datePublished und vor allem dateModified, gerade Letzteres, da es Aktualität signalisiert und diese gewichten KI-Suchsysteme stark.
- FAQPage: Frage-Antwort-Paare spiegeln genau das, was ein LLM ausgibt. Das Markup strukturiert Antworten für die direkte KI-Extraktion und wird mit deutlich höheren Zitationsraten in Verbindung gebracht.
- Wichtig zu beachten: Es sollte nur für „echte“ FAQs verwendet werden, handelt es sich eher um einen „Verkaufsblock“, kann das das Vertrauen schwächen.
- Product: Erhöht die Sichtbarkeit für transaktionale Anfragen und enthält Preis, Bewertungen und Verfügbarkeit, alles Signale, die die KI nutzt, wenn Nutzer nach „dem besten XY“ fragen.
- Weitere sinnvolle Auszeichnungen
- Person: als Teil von Organization stärkt sie EEAT über Autorenprofile.
- LocalBusiness: falls ein geografisches Einzugsgebiet bedient wird.
- BreadcrumbList – hilft der KI, die Position einer Seite in der Website-Struktur zu verstehen.
- HowTo: für echte Schritt-für-Schritt-Anleitungen.
Einordnung der Relevanz strukturierter Daten für LLMs
KIs verwenden strukturierte Daten, damit sie ihren Antworten Quellen zuordnen können. Bestenfalls verbessert die Einbindung strukturierter Daten die Sichtbarkeit bei KIs, im schlechtesten Fall passiert gar nichts.
LLMs generieren Text auf Basis von Wahrscheinlichkeiten und bevorzugen Informationen, die konsistent über ihre Trainingsdaten hinweg erscheinen. Wenn Öffnungszeiten auf der Website anders angegeben sind als auf Google My Business, verliert die KI das Vertrauen und lässt die Information ganz weg, da hilft auch kein Markup mehr.
Hochwertige Inhalte mit schlechten strukturierten Daten sind besser als schlechte Inhalte mit perfekter Auszeichnung!
Fazit: Strukturierte Daten übersetzen den Content in eine Sprache, die KI-Systeme direkt verarbeiten können ohne zu raten. Das erhöht die Chance, dass Deine Informationen korrekt verstanden und in einer Antwort verwendet werden.
Hebel 6: SEO-Basics – die unterschätzten Faktoren
Tiefe und Struktur zusammen machen Dich zitierbar und beides benötigt ein technisches Gerüst, das die einzelnen Bausteine sauber auslesbar macht.
Klare HTML-Struktur und zitierwürdige Inhalte
Hier hilft es darauf zu schauen, wie KI-Systeme Websites beim Beantworten verarbeiten. Denn sie lesen die URLs in der Regel nicht von oben bis unten, sondern ziehen sich gezielt Passagen, welche zur Nutzerfrage passen (auch wenn der Rest der Seite um etwas ganz anderes geht). Retrieval funktioniert auf Absatz-Ebene, nicht auf Seiten-Ebene. Genau deshalb bevorzugen diese Systeme Inhalte, die sich leicht in saubere, in sich abgeschlossene Häppchen zerlegen lassen („Chunks“).
Dafür ist eine klare semantische HTML-Struktur die Voraussetzung:
- Saubere Überschriften-Hierarchie: eine H1, darunter sinnvolle H2 und H3
- Textliche Inhalte:
- strukturierte Absätze
- Fragen und Antworten
- Listen und Tabellen statt Text in Bildern.
Dies erleichtert es KI-Crawlern einen einzelnen Abschnitt eindeutig zu erfassen und als Zitat zu verwenden. Das steht in keinem Widerspruch zur thematischen Tiefe von Inhalten. , dass vor allem in den AI Overviews Inhalte zitiert werden, die Themen sehr umfassend abdecken. Daher müssen Themen umfassend behandelt und gleichzeitig in klar abgegrenzte, eigenständige Abschnitte gegliedert sein.
Tipp: Frage Dich, wenn ein einzelner Absatz aus dem Kontext gerissen wird, ergibt er dann immer noch eine vollständige, korrekte Antwort? Dann ist er gut „zitierbar“.
Saubere Indexierung: Sitemaps, Canonicals, Statuscodes
Die Klassiker bleiben unverändert relevant. KI-Systeme ziehen ihre Quellen aus den klassischen Indizes, somit muss die Indexierung im klassischen SEO passen, denn sonst kommt Deine Seite nicht in den Pool, aus welchem zitiert wird. Somit ist eine saubere Indexierung kein „nice-to-have“die KI-Antworten.
Must-Haves sind:
- eine aktuelle XML-Sitemap,
- korrekte Canonical-Tags,
- saubere Statuscodes und
- keine unnötigen Weiterleitungsketten.
Noch relevanter ist, dass die Sitemap bestenfalls nicht nur in der Google Search Console, sondern auch in den Bing Webmaster Tools (Quelle für ChatGPT und teils bei Perplexity) eingereicht ist.
Fazit: Doppelte Inhalte, kaputte Links oder widersprüchliche Indexierungs-Signale verwirren jeden Crawler und kosten Dich im Zweifel die saubere, eindeutige URL, die zitiert werden könnte. Was Google durcheinanderbringt, bringt eine KI erst recht durcheinander.
Hebel 7: llms.txt – das Experiment
Die llms.txt ist eine Textdatei im Rootverzeichnis der Domain, welche KI-Systemen wichtige Fakten und Einstiegspunkte der Website bereitstellt. Dahinter steht die Idee: Statt sich mühsam durch unzählige URLs zu crawlen, bekommt der Crawler die wichtigsten Informationen in einem Aufwasch.
Bisher wurde die Nutzung der llms.txt nicht von KI-Anbietern bestätigt, somit ist ein Nutzen völlig unklar. Wenn eine KI die Datei benötigt, um den Inhalt einer Domain zu verstehen, solltest Du primär die gesamte Website überarbeiten.
Weitere KI-Optimierungsmöglichkeiten
Natürlich gibt es weitere Verbesserungsmöglichkeiten, die nicht unter das klassische „technische SEO“ fallen. Teilweise sind sie stark umstritten, hier einige der derzeit aktuellen Vorgehensweisen:
Groundingpage
Ein Thema, das in der SEO-Szene heiß diskutiert wird, ist die Grounding Page. Vereinfacht gesagt ist das eine bewusst nüchterne, faktenorientierte Seite, die einer KI eine eindeutige, zitierfähige Quelle hinsichtlich der Marke, des Unternehmens oder einer Person liefern soll.
Kurz: Sie soll eindeutig erklären, wer oder was die Entität ist und wovon sie sich abgrenzt. Ziel ist es, Verwechslungen und Halluzinationen vorzubeugen. Das Konzept ist allerdings umstritten.
Gut zu wissen: Das Konzept geht auf einen offenen Standard des SEO-Experten Hanns Kronenberg zurück und gehört klar in den Bereich GEO bzw. Entity-SEO und nicht ins technische SEO.
Gefällt Dir dieser Blogpost? Wenn Du regelmäßig die neuesten Trends im Online Marketing mitbekommen willst, dann abonniere jetzt unseren Newsletter. Zu Beginn des kostenlosen Abonnements bekommst Du täglich jeden Tag eine Mail, um Dich fit in SEO zu machen – 5 Tage lang. Über 83.000 Abonnenten vertrauen uns.
Authority durch Referenzierungen von Drittquellen (Linkbuilding)
KI-Systeme bewerten die Qualität einer Information (oder Marke) dadurch, dass sie die Fakten und Erwähnungen über viele unabhängige Quellen hinweg wiederfinden. Je öfter und je konsistenter Informationen im Web erwähnt, verlinkt und zitiert werden, desto wahrscheinlicher ziehen LLMs diese Information als verlässliche Quelle heran.
Wichtig: Es geht hier nicht um klassischen, bezahlten Link-Aufbau (dieser verstößt gegen die Google-Richtlinien und kann im schlimmsten Fall sogar schaden). Gemeint sind natürlich gewachsene Referenzen: echte Erwähnungen in der Fachpresse, hochwertige Gastbeiträge, Studien oder Daten, die andere freiwillig zitieren, Branchenverzeichnisse, Interviews oder Nennungen auf reichweitenstarken, themenrelevanten Seiten. Auch die reine Erwähnung des Marken- oder Produktnamens ist hilfreich, ganz ohne Link.
Einordnung: Diese Maßnahmen sind als Verstärker zu betrachten. Ohne ein sauberes technisches Fundament können sie ihre Wirkung nicht entfalten.
Fazit: KI-Sichtbarkeit geht nicht ohne SEO
Grundsätzlich ist die Begeisterung für GEO- und KI-Optimierung nachvollziehbar. Es ist ein neues, schnell wachsendes Feld und bringt frischen Wind in den Markt. Aber: Um eine hohe Sichtbarkeit in den LLMs zu haben, sind meist klassische SEO-Optimierungen nötig. Bremsen bezüglich KI-Sichtbarkeit sind beispielsweise:
- technische SEO-Probleme
- blockierte Suchbots
- Content, der nur per Java Script erscheint
- eine instabile, langsame Seite
- fehlende oder suboptimale Struktur
Somit ist SEO nicht tot, sondern gerade technisches SEO stellt wichtige Hebel für die LLM-Sichtbarkeit bereit. Können die Bots die Domain nicht erreichen, verarbeiten und verstehen, ist die perfekte Content-Strategie hinfällig.
Glücklicherweise musst Du für eine gute KI-Performance nicht bei null anfangen, denn wer eine solide technische SEO-Basis hat, hat den größten Teil der Hausaufgaben für die KI-Sichtbarkeit bereits erledigt. Falls das nicht sicher ist, ist jetzt der ideale Zeitpunkt, das Fundament zu prüfen. Wir helfen Dir gerne dabei: einfach bei uns nachfragen.
Bildrechte: Titelbild, Bild 1 & 3 erstellt mit DALL E (ChatGPT), Bild 2: eigene Grafik von Seokratie GmbH / Stefanie Niggemann.



Online Marketing & SEO
Endlich auch auf X: Bis zu 20 Bilder und Videos pro Post
Auf X können User endlich mehr als nur vier Bilder und Videos pro Post integrieren. Das bietet Raum für visuelles Storytelling.
Für Creator, Unternehmen und Marketer, aber auch für scrollende User ist diese Neuerung auf X von besonderem Interesse. Ab jetzt können die Posts mit 20 statt wie bisher nur vier Bildern und Videos versehen werden.
Mit dem neuen Video-Clipping-Feature möchte X derweil die Rezeption und Verbreitung von Videos auf der Plattform fördern.
X startet Clipping Feature für Videos
Mehr Raum für Visuals auf X
In einem Post mit elf Bildern hat Jonah Katz, Mobile Engineering Lead bei X, die neue Posting-Option für Posts auf der Plattform vorgestellt. Demnach sind nun 20 Visuals bei Beiträgen die Grenze. Das wurde auch Zeit. Immerhin können User bei der Konkurrenz von Instagram schon seit 2024 20 Visuals in Karussells integrieren. Für Threads kam die Option ebenfalls vor zwei Jahren. Und sogar die X-Konkurrenz Bluesky ermöglicht seit einigen Monaten immerhin die Integration von bis zu zehn Visuals in Posts – also deutlich mehr als bei der bisherigen X-Grenze von vier Bildern oder Videos.
Mit der neuen Option bietet sich für Creator und Unternehmen die Möglichkeit, anhand von Bildern und Videos noch mehr visuelles Storytelling auf der Plattform zu betreiben. Wer die Option noch nicht sieht, sollte die aktuellste App-Version nutzen. In unserem Test auf dem Desktop ist der Upload von mehr als vier Visuals bereits möglich.
Big update to the X platform today
After 10 years of Twitter/X supporting up to 4 Photos and Videos per post, the limit has been increased to 20!
Happy posting https://t.co/8hjclgo3rk
— Jonah Katz (@dinkin_flickaa) November 12, 2026
Wer Karussell-Posts dagegen lieber auf Instagram postet, kann diese seit Kurzem auch in der Bearbeitungs-App Edits direkt erstellen.
Du kannst jetzt Karussell-Posts in Edits erstellen
Stelle OnlineMarketing.de als bevorzugte Quelle auf Google ein
Wenn du OnlineMarketing.de auf Google als bevorzugte Quelle einstellen möchtest, um auch in den Schlagzeilen auf Google immer aktuelle News und Tipps aus der Welt des Marketing und der Tech-Entwicklungen zu finden, kannst du einfach die Google-Quelleneinstellungen aufrufen und die Seite anwählen. Über das Stern-Icon neben den Top Stories kannst du ebenfalls bevorzugte Quellen für die spätere Suche speichern.
Online Marketing & SEO
Start von „GTA VI”: YouTube mit Sonder-Features und Livestream
Den 19. November haben sich viele Gamer weltweit rot in den Kalender eingetragen, denn dann startet „GTA VI”. YouTube hat dafür einen 24-Stunden-Livestream, interaktive Funktionen im GTA-Stil und kostenlosen Merch angekündigt.
Der Launch von GTA VI gilt als einer der meist erwarteten, denn 13 Jahre lang haben Fans das neue Videospiel herbeigesehnt. Auch außerhalb der Gaming-Welt macht GTA VI bereits Schlagzeilen, da viele Unternehmen Fake-Krankmeldungen und dadurch Produktivitätsverluste befürchten. Unterdessen schürt YouTube die Vorfreude und bietet Fans und Interessierten ab jetzt interaktiven Begleit-Content zum Hype-Spiel des Jahres.
Am Donnerstag, den 19. November, geht es ab Mitternacht mit dem Spielspaß auf der PlayStation 5 und Xbox Series X/S los. Die Standard Edition kostet 80 Euro, die Ultimate Edition 100 Euro. In GTA VI wird es zum ersten Mal um ein potenzielles Liebespaar (Lucia und Jason) gehen. Zudem ist eine doppelt so große Map wie bei GTA V angekündigt sowie mehr Realismus bei den Fahrzeugen.
„GTA VI“ kommt und viele rechnen mit Krankmeldungen
Diese Extras kündigt YouTube zum Release Day an
Natürlich ist auch YouTube ganz vorne bei dem Hype dabei. Bereits jetzt hat die GTA-Reihe bisher über 900 Milliarden Aufrufe auf YouTube erreicht, wobei die Videos vor dem Release von GTA VI bereits über 40 Milliarden Aufrufe erreicht haben (Stand 13. November 2026). Zum Release Day hat das Unternehmen nun eine Kooperation mit Rockstar Games angekündigt, um die Community mit Creator-Inhalten und interaktiven Funktionen im GTA-Stil zu connecten.
YouTube hat einen internationalen 24-Stunden-Livestream angekündigt. Ab Mitternacht am 19. November können Fans weltweit auf youtube.com/youtube einen 24-Stunden-Stream mit Live Gameplay, Podcasts der Creator und exklusiven Inhalten von Creatorn wie Caylus , Zhong & Kat und Cinna verfolgen. Los geht es um 23 Uhr am Vortag mit einer Pre Show von RDCWorld und das Programm endet mit einer Live-Berichterstattung aus Miami.
Auch Merch wird zum Start verschenkt. So präsentiert YouTube Live fünf limitierte Geschenke im Gaming-Stil, darunter Kult-Animationen wie Wanted Stars, die während der Streams direkt auf den Bildschirmen erscheinen. Zum Auftakt können berechtigte Zuschauer:innen ausgewählter Creator Livestreams ein Geschenk von GTA VI kostenlos erhalten.
Mit GTA-Effekten in Vice City eintauchen
Zudem sollen Visit-Vice-City-Shorts-Effekte dafür sorgen, dass Fans direkt die Videospielstadt erleben können. Die Funktion biete dabei mehrere ikonische Hintergründe. Auch die Playlist von GTA VI wird präsent beworben in dieser Zeit.
Darüber hinaus kündigt das Unternehmen Insider-Infos an – von detaillierten Taktikanalysen und spannenden Storys bis hin zu exklusiven Einblicken hinter die Kulissen. Zudem hat das Kultur- und Trend-Team von YouTube eine ausführliche Analyse der anhaltenden kulturellen Wirkung von GTA veröffentlicht. Der Bericht analysiert, wie die filmische und immersive Welt das digitale Storytelling weiterentwickelt.
Stelle OnlineMarketing.de als bevorzugte Quelle auf Google ein
Wenn du OnlineMarketing.de auf Google als bevorzugte Quelle einstellen möchtest, um auch in den Schlagzeilen auf Google immer aktuelle News und Tipps aus der Welt des Marketing und der Tech-Entwicklungen zu finden, kannst du einfach die Google-Quelleneinstellungen aufrufen und die Seite anwählen. Über das Stern-Icon neben den Top Stories kannst du ebenfalls bevorzugte Quellen für die spätere Suche speichern.
Online Marketing & SEO
Diese Plattform bietet jetzt personalisierbare Likes
Mit Custom Likes auf Threads können User Emojis, Sticker und GIFs festlegen, die bei Usern erscheinen, wenn sie Posts und Antworten des Accounts liken.
Im Oktober startete Metas Threads einen Test, bei dem User die Likes für ihre Beiträge auf der Plattform selbst verändern können. Das Custom Likes Feature erlaubt es, eine etwas andere Reaktion als das klassische Herz-Icon erscheinen zu lassen, wenn User auf genau diesen Button tippen. Zwar erscheint selbst bei aktivierten Custom Likes am Ende das rote Herz in der unteren Leiste eines Posts. Doch als Like-Reaktion können sowohl GIFs und Sticker als auch Emojis ausgewählt werden, um für die User aufzutauchen. Das erklärte Threads-Chef Connor Hayes in seinem Post zum Test. Jetzt ist die Funktion umfassend ausgerollt worden, wie der offizielle Threads Account verkündet.
Um ein Custom Like für einen Beitrag oder eine Antwort einzustellen, können User im Post Composer der App auf das Herz-Icon tippen und aus den vorgegebenen Emojis, GIFs und Stickern etwas auswählen. Dabei können sie ihrer Kreativität freien Lauf lassen. So erhalten die Likes mehr Persönlichkeit und können zum Account passen. Ob es ein Fußball bei einem Post zum jüngsten Länderspiel der Klopp-Elf ist oder ein passendes Meme zu neuen Hit-Serien auf Netflix, Disney+ und Co. Die Auswahl ist groß.
Während erste User die Option bereits nutzen, können auch wir in unserem Test auf die Funktion zugreifen – allerdings nur mobil.
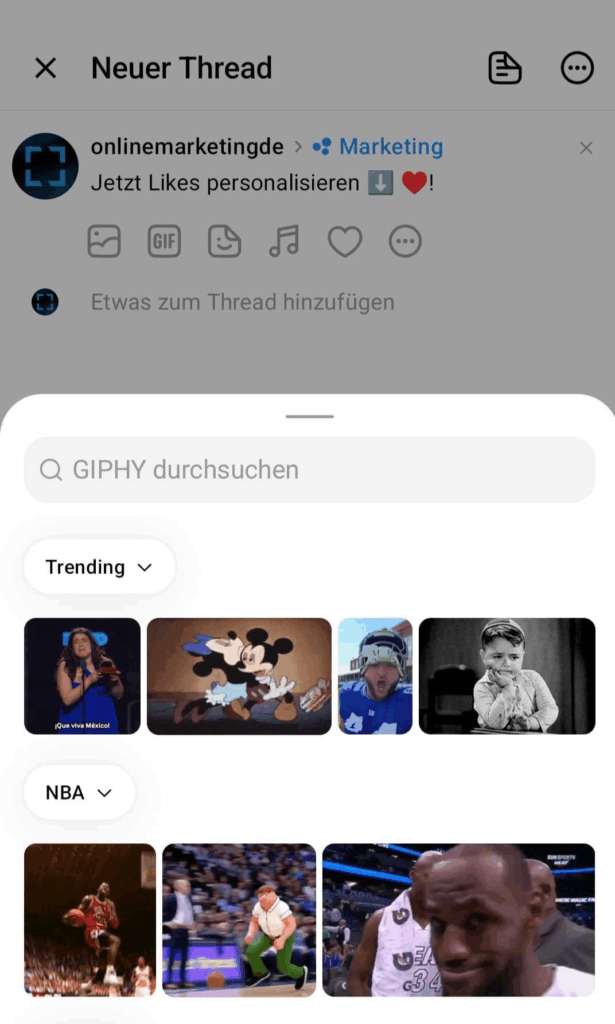
Probiere es doch gleich mal aus. Unterdessen gibt es auch für Creator auf der Konkurrenzplattform X große Neuigkeiten: Dort lassen sich jetzt statt wie bisher vier insgesamt bis zu 20 Bilder und Videos in Posts integrieren. Auf Threads ist das bereits möglich.
Meme it!
Threads arbeitet an Post Remixen und testet Custom Like Buttons

Stelle OnlineMarketing.de als bevorzugte Quelle auf Google ein
Wenn du OnlineMarketing.de auf Google als bevorzugte Quelle einstellen möchtest, um auch in den Schlagzeilen auf Google immer aktuelle News und Tipps aus der Welt des Marketing und der Tech-Entwicklungen zu finden, kannst du einfach die Google-Quelleneinstellungen aufrufen und die Seite anwählen. Über das Stern-Icon neben den Top Stories kannst du ebenfalls bevorzugte Quellen für die spätere Suche speichern.

Nintendo vs. Modchips: GitHub sperrt 144 Firmware-Repositories

Nach 6-Finger-Menschen: Crimson-Desert-Entwickler setzen stärker auf KI

Microsoft-Ausfall: Woran es lag und wer besonders litt

tado°: Smartes Wand-Thermostat ersetzt Batterien durch USB‑C‑Akku

Aqara Spatial Multi-Sensor FP400: Matter-Sensor erkennt bis zu 10 Personen mit mmWave‑Radar

Arm CSS for Mobile 2: C2-Ultra macht die CPU zum Orchestrator für KI‑Agenten
-
 Apps & Mobile Entwicklungvor 2 Monaten
tado°: Smartes Wand-Thermostat ersetzt Batterien durch USB‑C‑Akku
-
 Apps & Mobile Entwicklungvor 2 Monaten
Aqara Spatial Multi-Sensor FP400: Matter-Sensor erkennt bis zu 10 Personen mit mmWave‑Radar
-
 Apps & Mobile Entwicklungvor 2 Monaten
Arm CSS for Mobile 2: C2-Ultra macht die CPU zum Orchestrator für KI‑Agenten
-

 Künstliche Intelligenzvor 2 Monaten
Gesperrte Straße von Hormus: Laut Prognose werden CO₂-Emissionen 2026 sinken
-

 Künstliche Intelligenzvor 1 Monat
Verbrenner-Aus: Merz und Macron wollen CO₂-Ziel für 2035 weiter lockern
-

 Künstliche Intelligenzvor 2 Monaten
Plug-in-Hybride emittieren sechsmal mehr CO₂ im Alltag als offiziell angegeben
-

 Apps & Mobile Entwicklungvor 3 Monaten
Deutsche Lüfter-Ikone: ebm‑papst geht für 5,1 Milliarden Euro in die USA
-

 Künstliche Intelligenzvor 2 Monaten
Dänischer CO₂-Speicher „Greesand“ geht im Meeresgrund in Regelbetrieb